Pourquoi j'utilise Drizzle pour chaque backend TypeScript
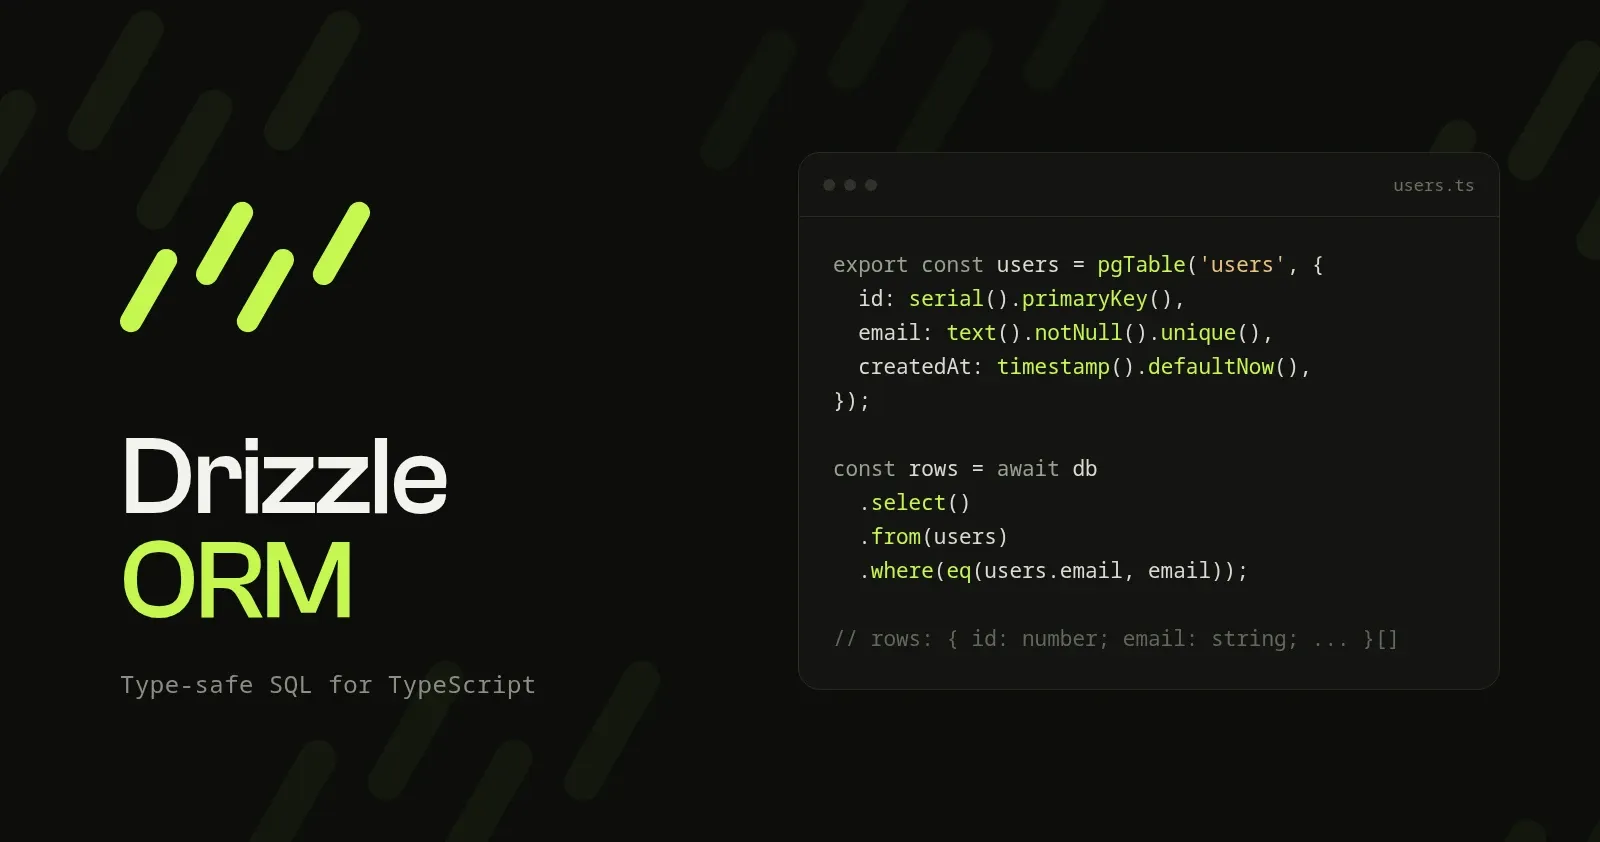
Le SQL brut n'a pas de types, et les ORM lourds cachent le SQL. Drizzle se place entre les deux : vous écrivez du TypeScript qui se lit comme du SQL, et chaque requête est typée à partir de votre schéma.
9 min de lecture
Dans cet article
- Qu’est-ce que Drizzle ?
- Drizzle et ses alternatives
- Pourquoi Drizzle est si bon
- Les types viennent du schéma
- Si vous connaissez le SQL, vous connaissez Drizzle
- Pas de magie
- Il tourne partout
- Drizzle Studio
- Installer Drizzle avec PostgreSQL
- Étape 1 : installer les dépendances
- Étape 2 : définir la chaîne de connexion
- Étape 3 : déclarer le schéma
- Étape 4 : déclarer les relations
- Étape 5 : créer le client de base de données
- Étape 6 : configurer Drizzle Kit
- Étape 7 : appliquer le schéma à la base
- Interroger la base
- Insérer
- Lire
- Modifier et supprimer
- Les jointures
- Les requêtes relationnelles
- Les transactions
- Bonnes pratiques
- Commitez vos migrations
- Gardez push pour le prototypage
- Un fichier de schéma par domaine
- Validez les entrées avant qu’elles n’atteignent la base
- Conclusion
Tout backend finit par parler à une base de données. En TypeScript, il existe deux façons courantes de le faire, et toutes deux ont un coût.
Écrire du SQL brut garde un contrôle total, mais les résultats reviennent sans types. Une colonne renommée ou une faute de frappe dans une requête ne se découvre qu’à l’exécution. Les ORM traditionnels règlent le problème des types, mais cachent le SQL derrière leurs propres abstractions, et il devient difficile de savoir quelles requêtes partent vraiment vers la base.
Dans cet article, j’explique pourquoi Drizzle ORM est devenu mon choix par défaut pour les backends TypeScript, comment il se compare aux alternatives, et comment l’installer de zéro avec PostgreSQL : le schéma, les migrations, les requêtes, les relations et les transactions.
Qu’est-ce que Drizzle ?
Drizzle ORM est un ORM TypeScript qui décrit le schéma de la base en TypeScript et propose des requêtes qui ressemblent à du SQL.
Sa philosophie tient en une phrase de sa documentation : si vous connaissez le SQL, vous connaissez Drizzle.
Drizzle repose sur trois idées :
- Le schéma est du code TypeScript. Tables, colonnes, index et clés étrangères sont déclarés dans des fichiers
.ts. - Les requêtes reflètent le SQL.
select,from,where,joinetorderByse lisent comme le SQL qu’ils produisent. - Les types sont déduits. Chaque résultat de requête est typé à partir du schéma, sans étape de génération de code.
Drizzle est accompagné d’un outil, Drizzle Kit, qui génère et applique les migrations à partir du schéma.
Drizzle et ses alternatives
| Outil | Schéma défini dans | Style de requête | Idéal pour |
|---|---|---|---|
| SQL brut | La base de données | Des chaînes SQL | Un contrôle total, sans types |
| Prisma | Son propre langage de schéma | Un client généré avec sa propre API | Les équipes qui préfèrent éviter le SQL |
| TypeORM | Des classes et des décorateurs | Repositories et entités | Les bases de code orientées objet |
| Kysely | Des types TypeScript | Un query builder typé | Du SQL typé sans ORM |
| Drizzle | Du code TypeScript | Un builder proche du SQL et une API relationnelle | Du SQL typé avec un schéma et des migrations |
Chaque outil est un choix valable. Drizzle se distingue parce qu’il réunit ce qui est d’habitude réparti entre plusieurs outils : un schéma écrit en TypeScript, des migrations générées depuis ce schéma, et des requêtes qui restent proches du SQL.
Pourquoi Drizzle est si bon
Les types viennent du schéma
Source : documentation de Drizzle, Get started with PostgreSQL.
Une table est déclarée une fois, et ses types suivent :
type User = typeof users.$inferSelect;    // une ligne lue dans la table
type NewUser = typeof users.$inferInsert; // une ligne à insérer
$inferInsert sait quelles colonnes sont facultatives, comme les identifiants générés ou les colonnes avec une valeur par défaut. Ajouter une colonne à la table met les deux types à jour immédiatement.
Si vous connaissez le SQL, vous connaissez Drizzle
Source : documentation de Drizzle, Select.
Pas de nouveau langage de requête à apprendre. Une requête Drizzle et le SQL qu’elle produit se ressemblent :
await db.select().from(users).where(eq(users.id, 42));select "id", "name", "age" from "users" where "users"."id" = $1; -- params: [42]Les valeurs sont toujours envoyées en paramètres, jamais concaténées dans la requête, ce qui protège contre l’injection SQL.
Pas de magie
Drizzle ne génère pas de client, ne cache pas de requêtes derrière du chargement paresseux, et ne fait pas tourner son propre moteur à côté de l’application. Ce que vous écrivez est ce qui s’exécute.
Il tourne partout
Drizzle est léger et prend en charge de nombreux drivers : node-postgres, Postgres.js, Neon, Supabase, PGlite, MySQL, SQLite, Cloudflare D1 et d’autres. Le même schéma et les mêmes requêtes fonctionnent sur un serveur Node.js classique, dans des fonctions serverless et sur l’edge.
Drizzle Studio
Source : documentation de Drizzle, Drizzle Kit.
Drizzle Kit inclut un explorateur de base de données qui lit votre schéma :
npx drizzle-kit studioC’est un moyen pratique d’inspecter et de modifier les données en développement, sans installer d’autre outil.
Installer Drizzle avec PostgreSQL
Les exemples suivent la documentation officielle, qui cible désormais Drizzle 1.0, installé depuis le tag rc. Les projets encore en version 0.x utilisent une API légèrement différente pour les relations.
Chaque extrait de code de cet article vient de la documentation officielle de Drizzle, parfois adapté aux mêmes tables users et posts. Chaque section renvoie à la page d’où il vient.
Étape 1 : installer les dépendances
Source : documentation de Drizzle, Get started with PostgreSQL.
npm i drizzle-orm@rc pg dotenv
npm i -D drizzle-kit@rc tsx @types/pgdrizzle-ormest l’ORM lui-mêmepgest le driver PostgreSQL (node-postgres)drizzle-kitgénère et applique les migrations
Étape 2 : définir la chaîne de connexion
Source : documentation de Drizzle, Get started with PostgreSQL.
DATABASE_URL=postgres://user:password@localhost:5432/appNe commitez jamais ce fichier.
Étape 3 : déclarer le schéma
Source : documentation de Drizzle, Get started with PostgreSQL.
// src/db/schema.ts

import { index, integer, pgTable, text, varchar } from 'drizzle-orm/pg-core';

export const users = pgTable('users', {
    id: integer().primaryKey().generatedAlwaysAsIdentity(),
    name: varchar({ length: 255 }).notNull(),
    age: integer().notNull(),
    email: varchar({ length: 255 }).notNull().unique(),
});

export const posts = pgTable(
    'posts',
    {
        id: integer().primaryKey().generatedAlwaysAsIdentity(),
        content: text().notNull(),
        ownerId: integer('owner_id').references(() => users.id),
    },
    (table) => [index('posts_owner_idx').on(table.ownerId)]
);
Ce schéma :
- Utilise des colonnes d’identité pour les clés primaires
- Rend l’email unique
- Relie chaque post à son auteur par une clé étrangère
- Indexe
owner_id, la colonne utilisée pour retrouver les posts d’un utilisateur
Le nom de la propriété sert en TypeScript, et le premier argument d’une colonne, comme 'owner_id', est le nom utilisé dans la base.
Étape 4 : déclarer les relations
Source : documentation de Drizzle, Relations.
Les clés étrangères décrivent la base. Les relations décrivent comment Drizzle doit charger les lignes liées dans les requêtes relationnelles :
// src/db/relations.ts

import { defineRelations } from 'drizzle-orm';
import * as schema from './schema';

export const relations = defineRelations(schema, (r) => ({
    users: {
        posts: r.many.posts(),
    },
    posts: {
        author: r.one.users({
            from: r.posts.ownerId,
            to: r.users.id,
        }),
    },
}));
Étape 5 : créer le client de base de données
Source : documentation de Drizzle, Get started with PostgreSQL.
// src/db/index.ts

import 'dotenv/config';
import { drizzle } from 'drizzle-orm/node-postgres';
import { Pool } from 'pg';
import { relations } from './relations';

const pool = new Pool({
    connectionString: process.env.DATABASE_URL!,
});

export const db = drizzle({ client: pool, relations });
Le reste de l’application importe db et ne crée jamais sa propre connexion.
Étape 6 : configurer Drizzle Kit
Source : documentation de Drizzle, Get started with PostgreSQL.
// drizzle.config.ts

import 'dotenv/config';
import { defineConfig } from 'drizzle-kit';

export default defineConfig({
    out: './drizzle',
    schema: './src/db/schema.ts',
    dialect: 'postgresql',
    dbCredentials: {
        url: process.env.DATABASE_URL!,
    },
});
Étape 7 : appliquer le schéma à la base
Source : documentation de Drizzle, Migrations.
Drizzle Kit propose deux façons de faire principales.
Push
npx drizzle-kit pushpush compare le schéma à la base et applique directement les différences, sans créer de fichiers de migration. C’est idéal pour prototyper.
Generate et migrate
npx drizzle-kit generate
npx drizzle-kit migrate
generate écrit un fichier de migration SQL dans le dossier drizzle, et migrate applique les migrations qui n’ont pas encore été jouées.
Les migrations peuvent aussi être appliquées au démarrage de l’application :
import { migrate } from 'drizzle-orm/node-postgres/migrator';

await migrate(db);
Pour tout ce qui ira en production, je recommande les migrations générées : ce sont de simples fichiers SQL qu’on peut relire et commiter avec le code.
Interroger la base
Insérer
Source : documentation de Drizzle, Insert.
import { users } from './db/schema';

const user: typeof users.$inferInsert = {
    name: 'John',
    age: 30,
    email: '[email protected]',
};

await db.insert(users).values(user);
En PostgreSQL, returning() renvoie la ligne insérée, ou seulement les colonnes demandées :
const [created] = await db.insert(users).values(user).returning();

const [{ insertedId }] = await db
    .insert(users)
    .values({ name: 'Dan', age: 25, email: '[email protected]' })
    .returning({ insertedId: users.id });
Lire
Source : documentation de Drizzle, Select.
import { eq } from 'drizzle-orm';

const allUsers = await db.select().from(users);
// { id: number; name: string; age: number; email: string }[]

const john = await db
    .select()
    .from(users)
    .where(eq(users.email, '[email protected]'));
Un select partiel ne renvoie que les colonnes demandées, et le type suit :
const emails = await db
    .select({ id: users.id, email: users.email })
    .from(users);
// { id: number; email: string }[]
Les conditions se combinent avec des fonctions comme and, or, gt et ilike. Une condition undefined est simplement ignorée, ce qui rend les filtres facultatifs faciles :
import { ilike } from 'drizzle-orm';

const searchPosts = async (term?: string) => {
    return db
        .select()
        .from(posts)
        .where(term ? ilike(posts.content, term) : undefined);
};
Modifier et supprimer
Source : documentation de Drizzle, Get started with PostgreSQL.
await db
    .update(users)
    .set({ age: 31 })
    .where(eq(users.email, '[email protected]'));

await db.delete(users).where(eq(users.email, '[email protected]'));
Les jointures
Source : documentation de Drizzle, Joins.
const result = await db
    .select()
    .from(users)
    .leftJoin(posts, eq(users.id, posts.ownerId));
Le résultat est typé, y compris le fait qu’une jointure gauche peut ne renvoyer aucun post :
const result: {
    users: { id: number; name: string; age: number; email: string };
    posts: { id: number; content: string; ownerId: number | null } | null;
}[];
Les requêtes relationnelles
Source : documentation de Drizzle, Relational queries.
Pour des données imbriquées, l’API relationnelle charge les lignes avec leurs relations en une seule requête :
const usersWithPosts = await db.query.users.findMany({
    with: {
        posts: true,
    },
});

const user = await db.query.users.findFirst({
    where: {
        id: 1,
    },
    with: {
        posts: true,
    },
});
Chaque utilisateur revient avec un tableau posts, typé à partir du schéma. findFirst() ajoute limit 1 à la requête.
Les transactions
Source : documentation de Drizzle, Transactions.
Une transaction regroupe plusieurs requêtes qui doivent réussir ou échouer ensemble. Cet exemple de la documentation transfère de l’argent entre deux comptes :
await db.transaction(async (tx) => {
    const [account] = await tx
        .select({ balance: accounts.balance })
        .from(accounts)
        .where(eq(users.name, 'Dan'));

    if (account.balance < 100) {
        // Lève une exception qui annule la transaction.
        tx.rollback();
    }

    await tx.update(accounts).set({ balance: sql`${accounts.balance} - 100.00` }).where(eq(users.name, 'Dan'));
    await tx.update(accounts).set({ balance: sql`${accounts.balance} + 100.00` }).where(eq(users.name, 'Andrew'));
});
Si une requête échoue, ou si tx.rollback() est appelé, aucune des modifications n’est conservée.
Bonnes pratiques
Commitez vos migrations
Les migrations générées font partie du code. Relisez-les comme n’importe quel changement, et commitez-les avec la modification du schéma qui les a produites.
Gardez push pour le prototypage
drizzle-kit push est rapide, mais ne laisse aucun historique. Dès qu’une base contient de vraies données, passez à generate et migrate.
Un fichier de schéma par domaine
Quand l’application grandit, découpez le schéma en plusieurs fichiers, comme users.ts, billing.ts ou posts.ts, et faites pointer schema dans la configuration vers le dossier.
Validez les entrées avant qu’elles n’atteignent la base
Source : documentation de Drizzle, drizzle-zod.
Le schéma décrit la base, pas ce que les clients ont le droit d’envoyer. Drizzle peut générer des schémas Zod à partir des tables :
import { createInsertSchema } from 'drizzle-orm/zod';

const userInsertSchema = createInsertSchema(users);

const parsed = userInsertSchema.parse(input);
await db.insert(users).values(parsed);
Les règles de validation restent synchronisées avec la table, et les données invalides sont refusées avant que la requête ne parte.
Conclusion
Drizzle donne aux backends TypeScript ce qui manque au SQL brut comme aux ORM traditionnels : le contrôle et la lisibilité du SQL, avec des types qui viennent directement du schéma.
Dans cet article, nous avons vu ce qu’est Drizzle, comment il se compare à Prisma, TypeORM et Kysely, et pourquoi il est devenu mon choix par défaut. Nous l’avons ensuite installé avec PostgreSQL, du schéma et des relations jusqu’aux migrations, aux requêtes et aux transactions.
Ce qui en fait mon choix pour chaque backend TypeScript :
- Un schéma écrit en TypeScript, d’où les types sont déduits
- Des requêtes qui se lisent comme le SQL qu’elles produisent
- Des migrations générées depuis le schéma, en simples fichiers SQL
- Une petite bibliothèque qui tourne sur un serveur, en serverless et sur l’edge
Le meilleur outil est celui qui se fait oublier. Avec Drizzle, la base reste du SQL, le code reste du TypeScript, et le compilateur vérifie que les deux sont d’accord.